개인 프로젝트 진행 중
창고 로봇(AMR) 텔레메트리 실시간 데이터 파이프라인
Kiva 계열 창고 자동화 로봇의 위치·배터리·작업 이벤트를 합성 데이터로 생성해, 데이터 특성별로 Kafka Topic·저장소·acks 전략을 다르게 설계하고 Grafana로 Fleet 운영 지표를 모니터링하는 파이프라인을 설계·구축 중인 개인 프로젝트입니다.
Overview
창고 내 AMR(자율이동로봇) 10대가 Pod(이동식 선반)를 들어올려 피킹 스테이션으로 운반하는 시나리오를 합성 데이터 생성기로 시뮬레이션하고, 이 데이터를 Kafka 기반 파이프라인으로 수집·적재·모니터링합니다. 위치·배터리·작업 이벤트라는 세 가지 데이터가 서로 다른 특성(빈도, 유실 허용도)을 갖는다는 점에 착안해, Topic 분리부터 저장소 선택까지 하나의 일관된 설계 기준으로 구성했습니다.
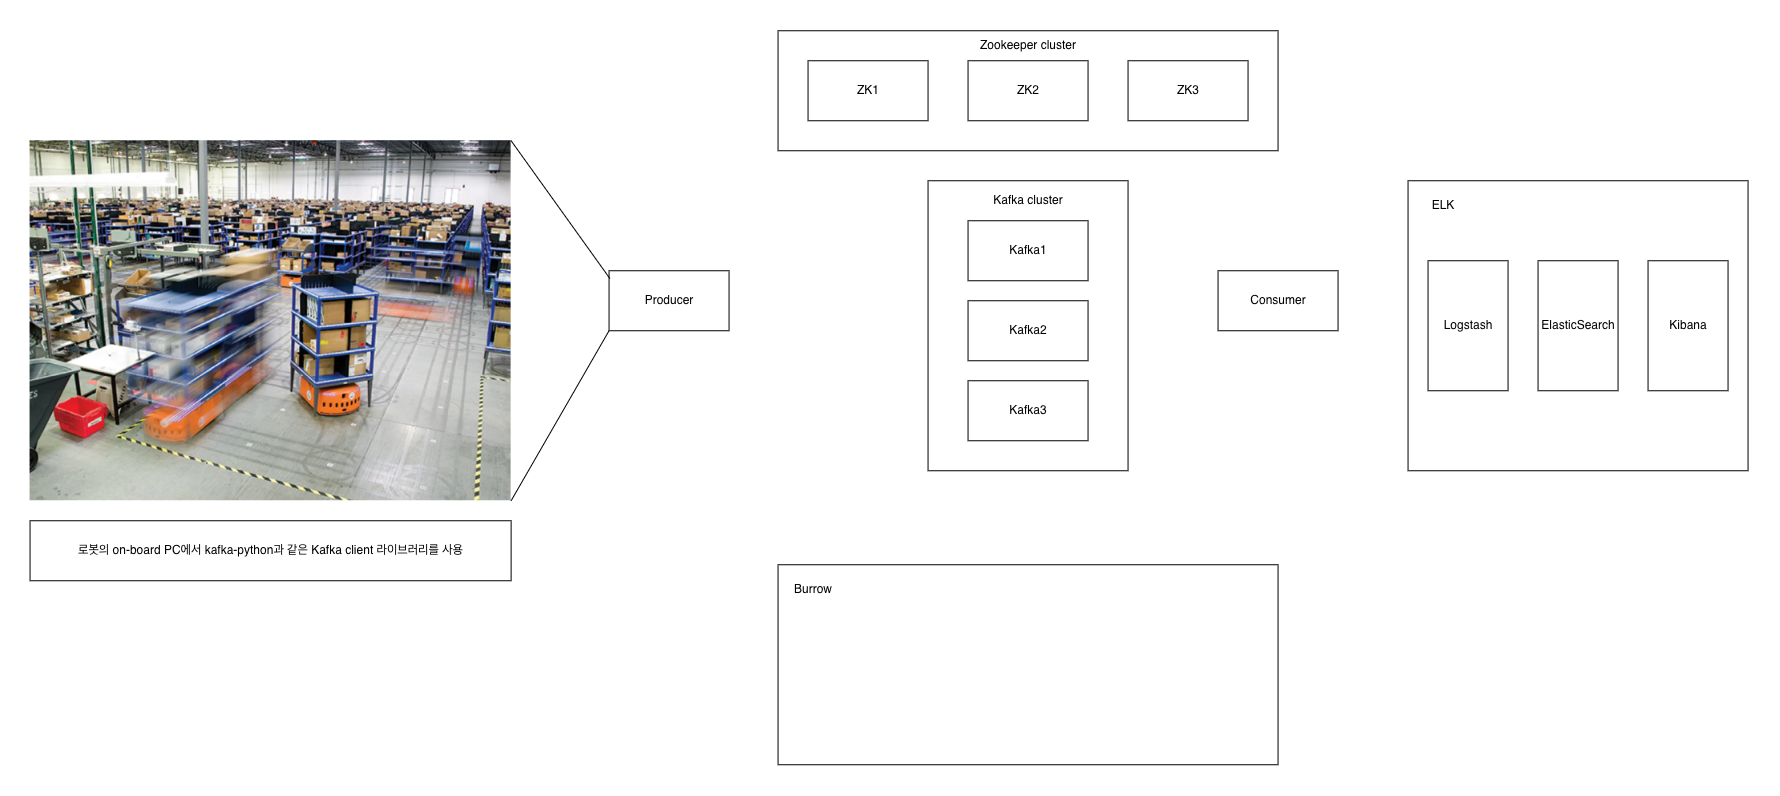
System Architecture
Constraints
- 실제 물류 자동화 로봇(Kiva 계열) 하드웨어 없이, 합성 데이터 생성기로 현실적인 텔레메트리를 만들어야 함
- 위치(고빈도·유실 허용) / 배터리(중빈도) / 작업 이벤트(저빈도·유실 불가)라는 서로 다른 데이터 특성을 하나의 파이프라인 안에서 각각에 맞게 처리해야 함
- GPU 기반 로봇 시뮬레이터(Isaac Sim) 대신 가벼운 방식으로 대체하되, 도메인 신뢰도는 유지해야 함
- 배포 인프라를 처음부터 K8s로 시작하지 않고, 학습 중인 K3s·K8s 개념을 단계적으로 반영해야 함
Tech Stack
- Apache Kafka (Docker, 3 broker)
- Python (합성 데이터 생성기 — 확률 모델 기반 로봇 상태 시뮬레이션)
- TimescaleDB (PostgreSQL 확장 — 위치·배터리 시계열 데이터)
- Elasticsearch (작업 이벤트 데이터)
- Grafana (Fleet 가동률, Consumer Lag, 병목 구간 모니터링)
- K3s → Kubernetes (단계적 배포 확장)
- Apache Airflow (일일 집계 배치 — 확장 예정)
- GitLab CI/CD
Learnings
- 이 프로젝트는 4년 전 개인 학습 프로젝트(Kafka+ELK+Grafana, Twitter 데이터 기반)에서 겪었던 교훈 — 특히 Docker 멀티 브로커 환경에서 KAFKA_ADVERTISED_HOST_NAME을 localhost로 두면 안 된다는 것, acks=1과 acks=-1의 트레이드오프 — 을 이어받아, 이번에는 도메인과 설계 판단 자체를 중심에 두고 재구성한 결과입니다.
- 실무 시뮬레이터(Isaac Sim)가 항상 정답은 아니라는 것을 확인했습니다. 지원 직무가 실제로 평가하는 지점이 무엇인지 먼저 판단하고, 거기에 맞춰 도구를 가볍게 대체하는 결정도 엔지니어링 판단의 일부라고 생각합니다.
- Kafka Topic 설계를 '몇 개로 나눌까'가 아니라 '데이터가 유실되면 어떤 일이 생기는가'를 기준으로 접근하니, acks·저장소·retention 같은 이후의 모든 결정이 하나의 논리로 자연스럽게 이어졌습니다.