실무

Hadoop 에코시스템 기반 엔터프라이즈 데이터 플랫폼 구축 및 고도화

Data Engineer · 2024 · 4 min read 읽기 · GitHub 저장소

Docker Compose로 HDFS HA·Kafka·Flink·Hive·HBase 데이터 플랫폼을 구축하고, 1TB 로그 기준 저장소 성능 비교로 배치(Hive)·실시간(HBase) 역할을 분리했으며, 구간별 관측으로 적재 병목을 규명해 성능을 개선

Overview

Hadoop 생태계 기반 데이터 플랫폼의 구축과 적재 파이프라인 성능 개선을 담당했습니다. ElasticSearch·Hive·HBase를 1TB 로그 데이터 기준으로 비교해 저장소 구성을 정하고, 공공 기상 데이터를 Kafka와 Flink를 거쳐 HDFS에 적재하는 플랫폼을 컨테이너로 구성했습니다.

데이터는 실시간성·배치성 두 갈래로 유입되는데, 적재 성능 지표가 낮게 나오는 원인을 감이 아니라 구간별 측정으로 규명하고, 미들(producer)–큐(Kafka)–저장소(Hive/HBase)를 end-to-end 관점에서 개선했습니다.

System Architecture
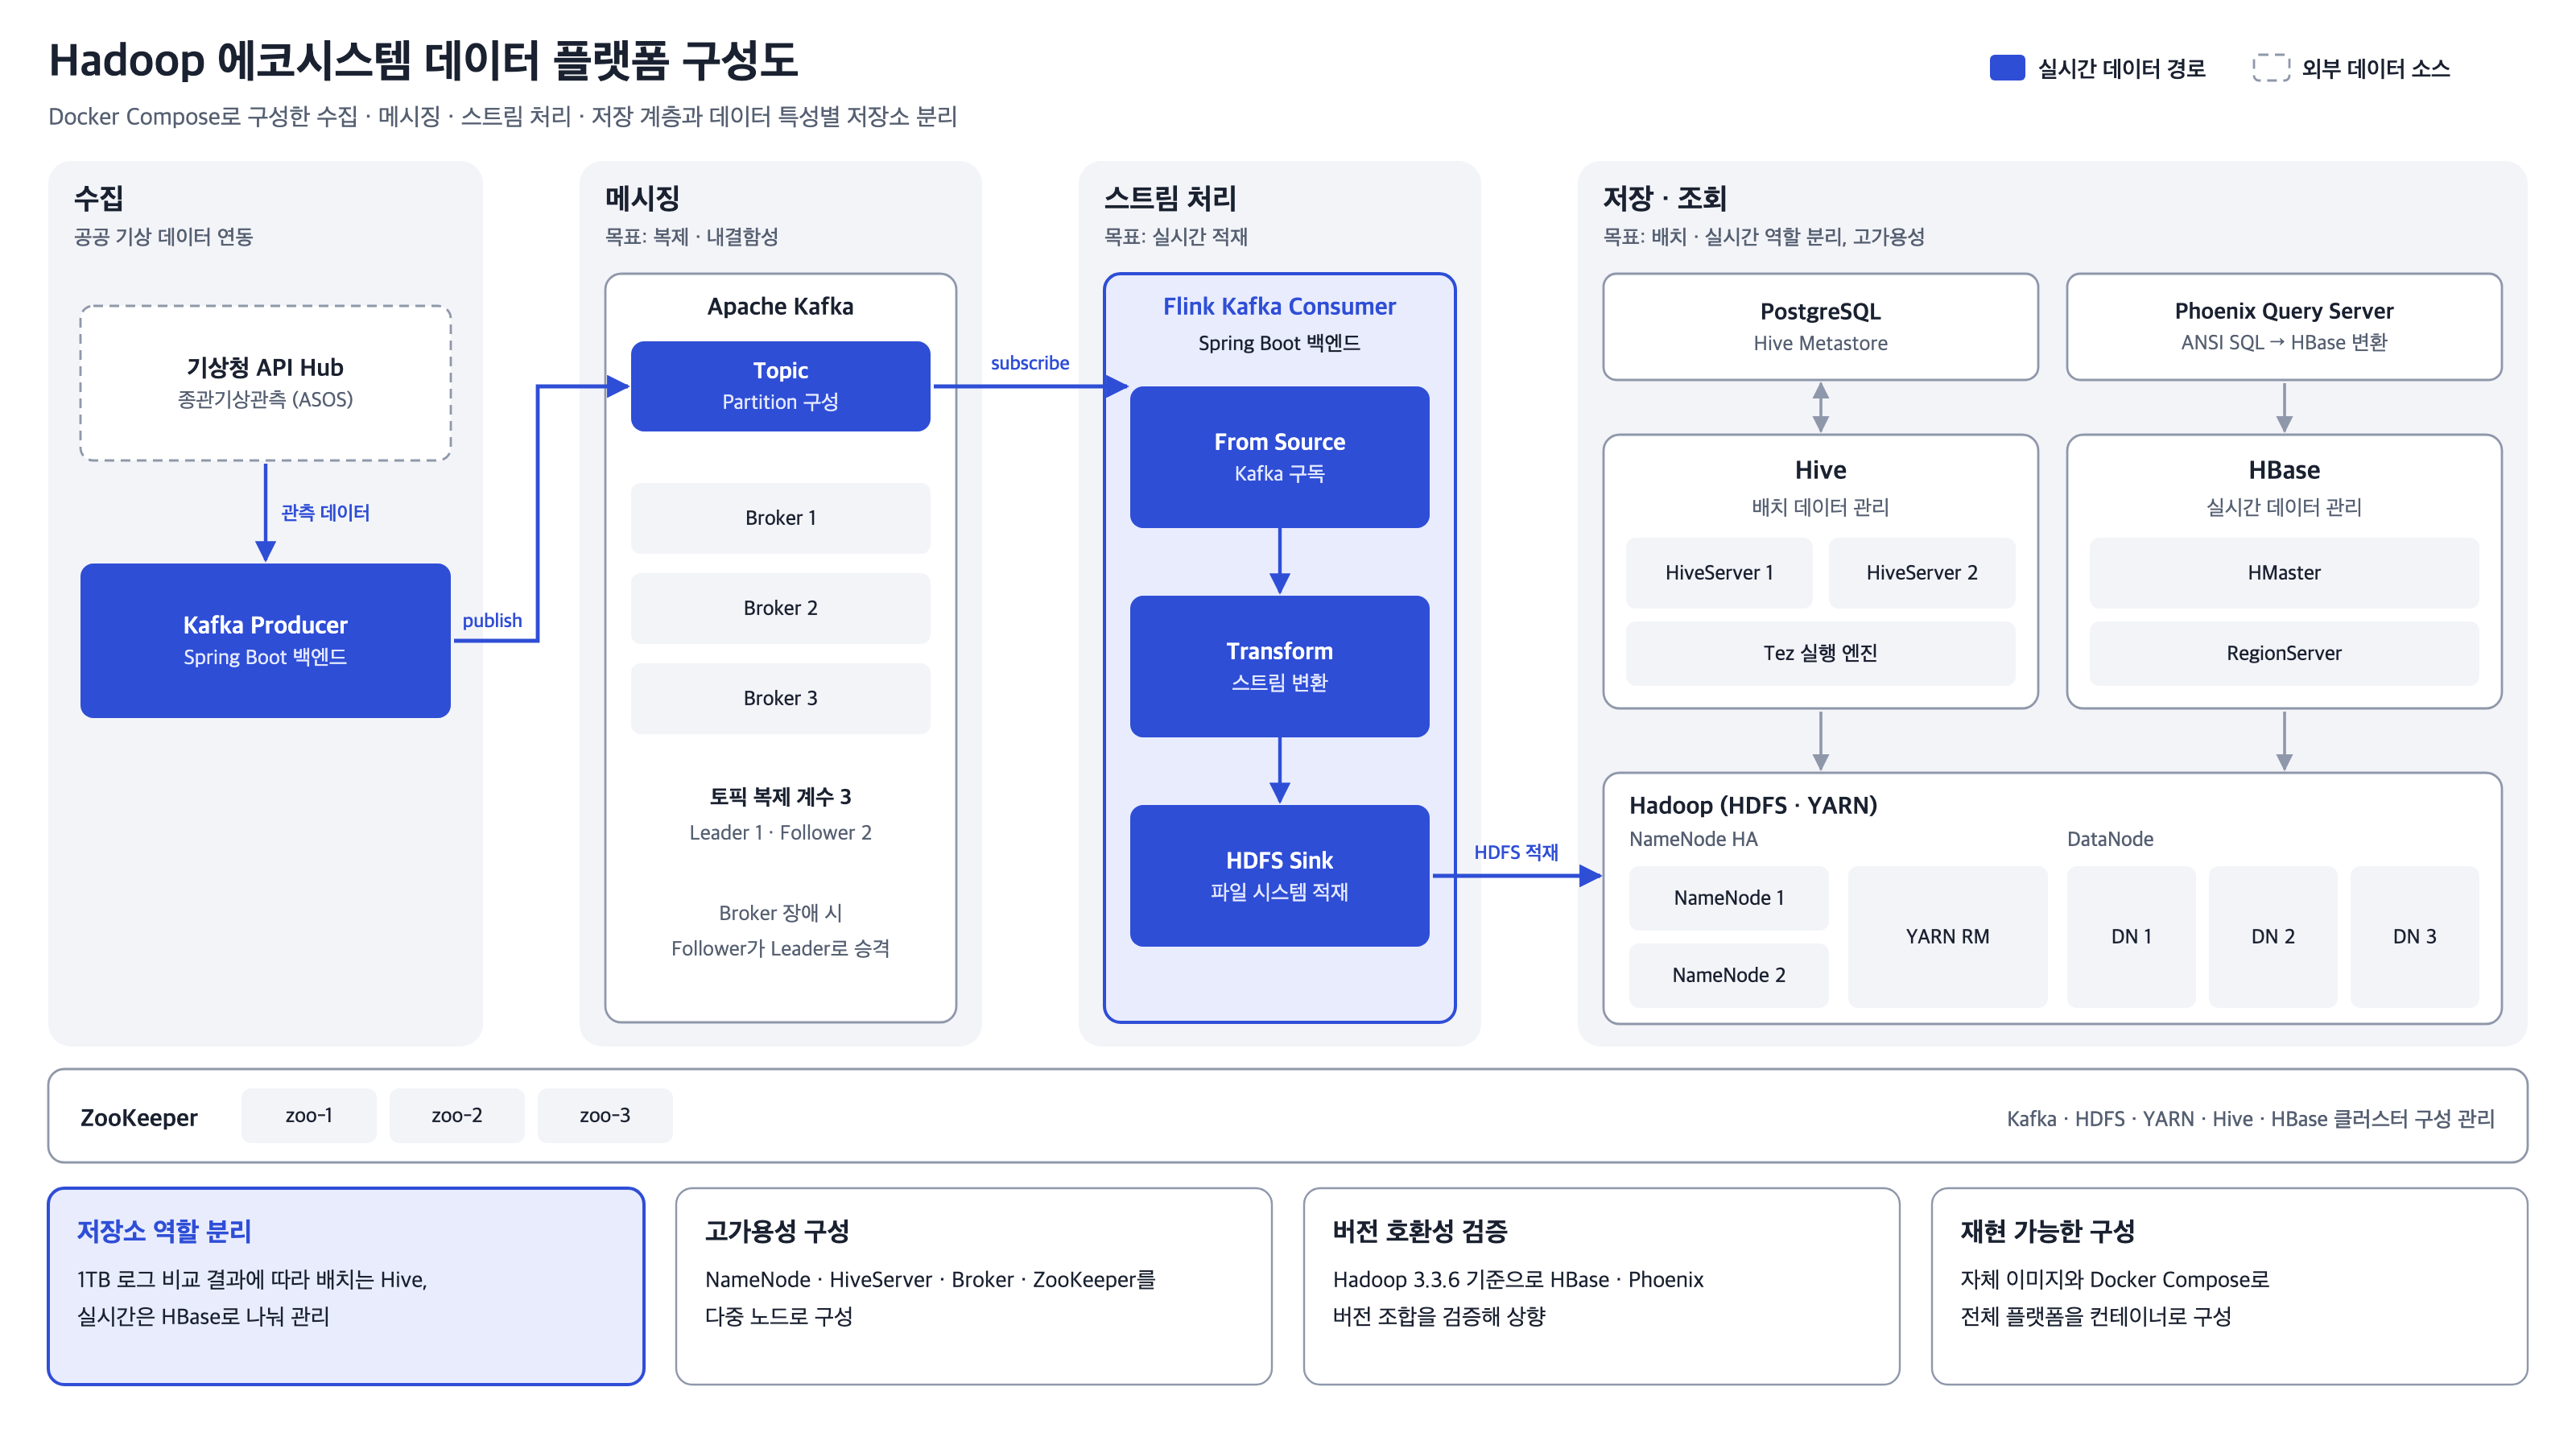
Hadoop 데이터 플랫폼 구성도 — 기상 데이터를 Kafka와 Flink로 HDFS에 적재하고 Hive·HBase로 관리하는 Docker 기반 구조
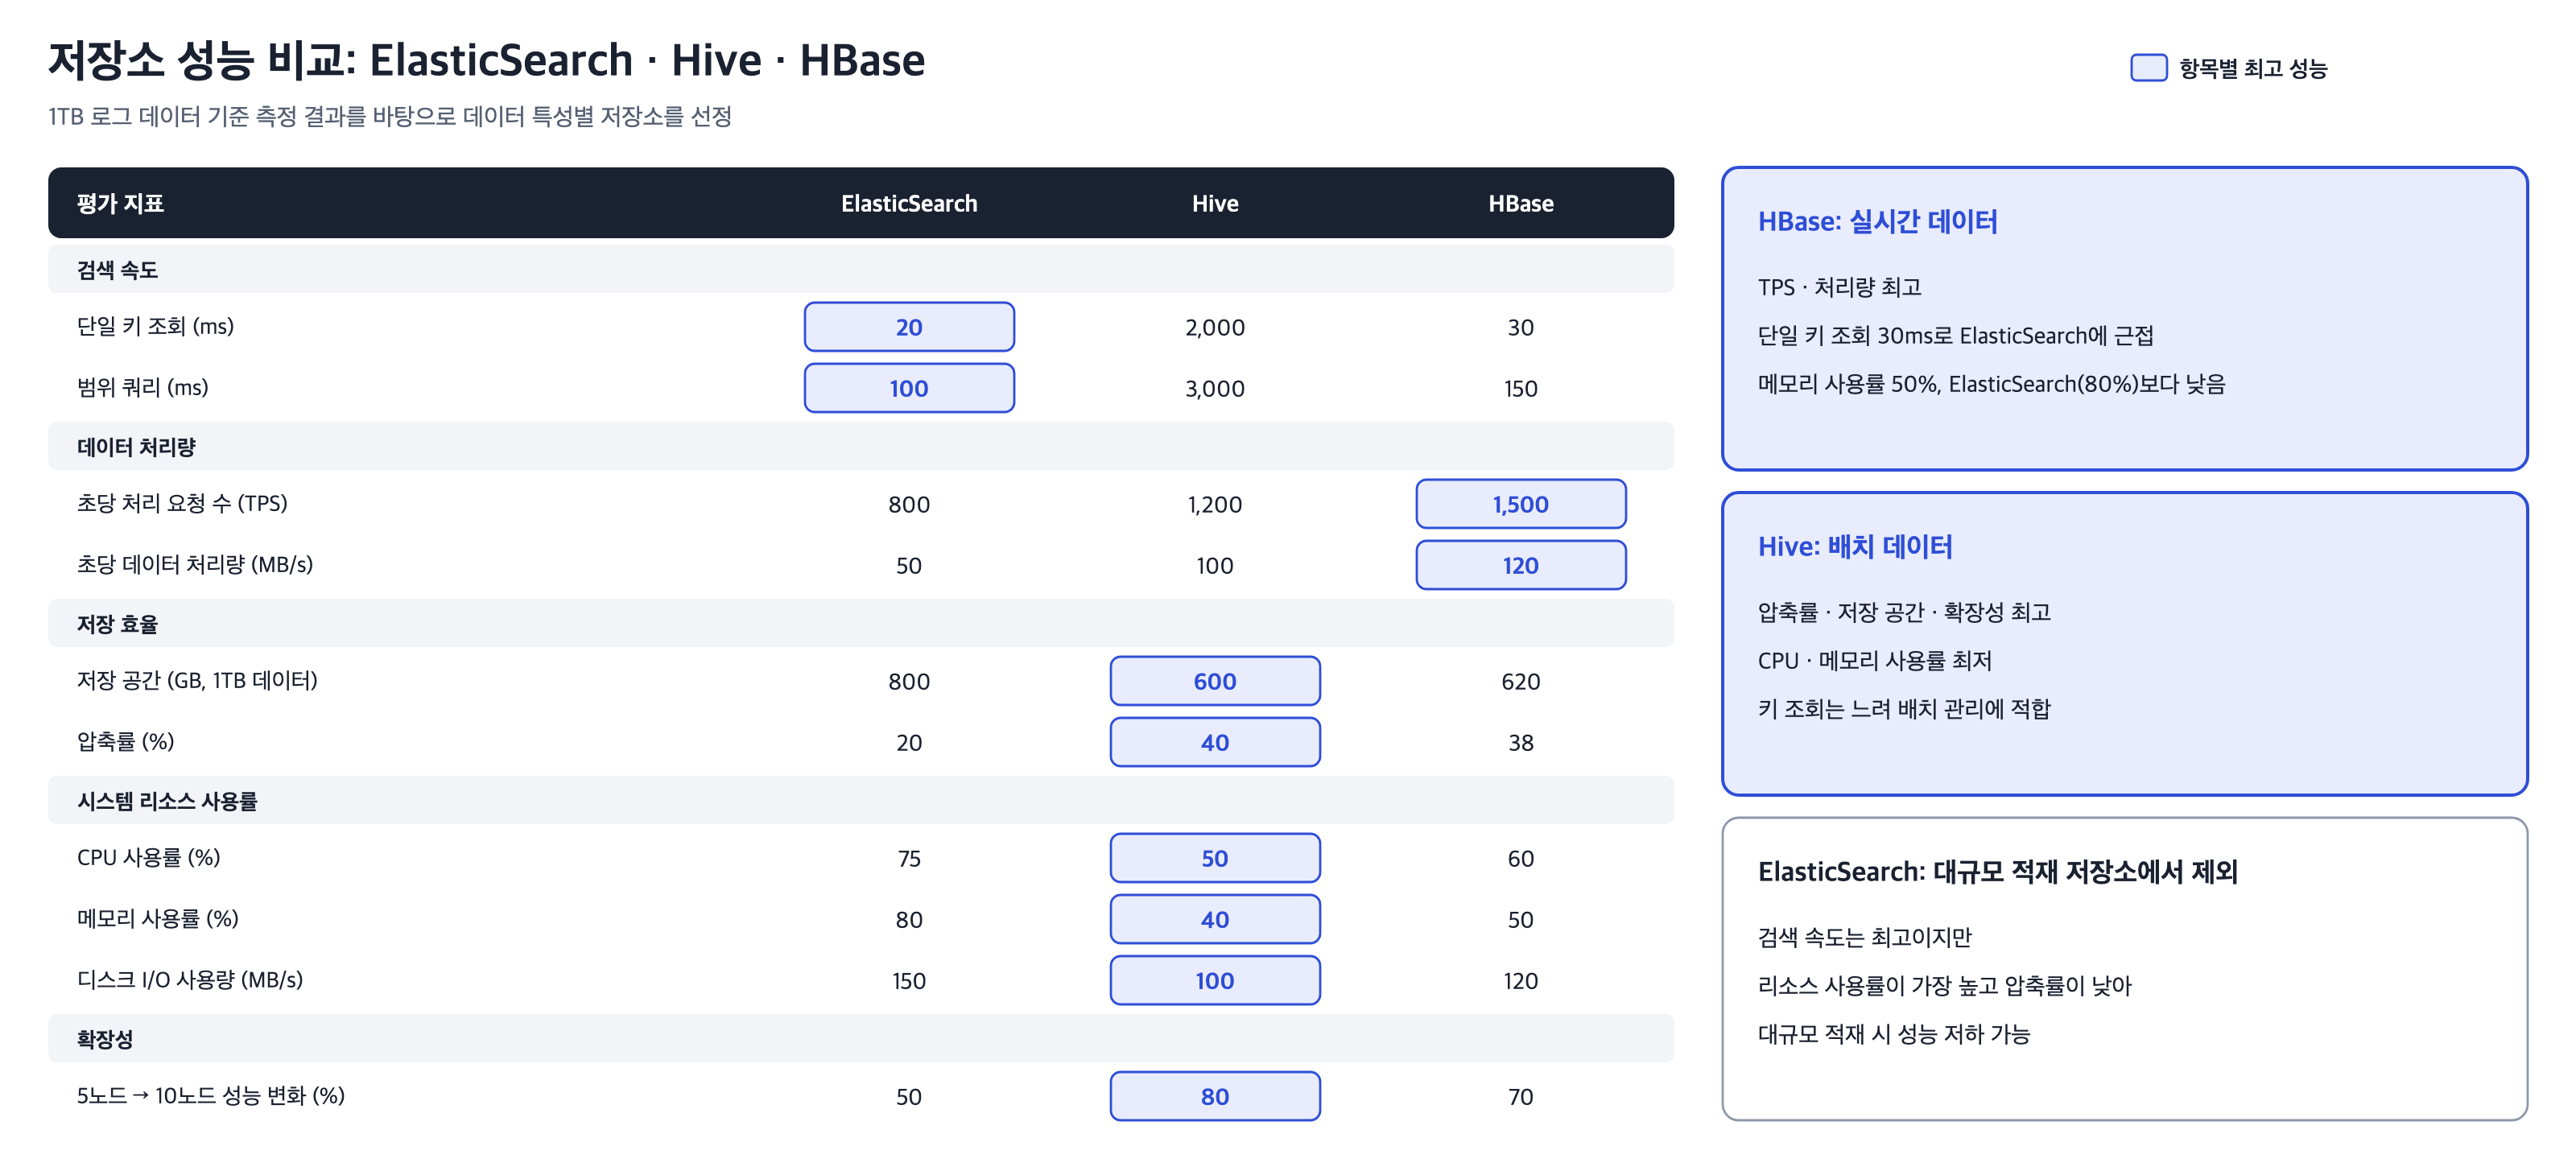
1TB 로그 데이터 기준 ElasticSearch·Hive·HBase 성능 비교표와 데이터 특성별 저장소 선정 결과

Constraints

  • 데이터가 실시간성·배치성 두 갈래로 동시에 유입
  • 주 저장소 Hive는 배치 대량 적재 특성 — 건by건 처리와 상성이 나쁨
  • HBase는 표준 SQL과 문법이 달라 Phoenix 변환 계층을 경유해야 함
  • Spark 내부는 외부에서 세부 성능 지표를 측정할 수 없는 블랙박스
  • Dataset 정의부에 종속 관계 존재 — 상위 정의가 하위에 우선 반영돼야 함

Tech Stack

  • Hadoop Ecosystem (HDFS HA · YARN)
  • Docker Compose
  • ZooKeeper
  • Apache Flink
  • Spring Boot
  • Apache Tez · PostgreSQL (Hive Metastore)
  • Apache Hive
  • Apache HBase + Apache Phoenix
  • Apache Kafka
  • Apache Spark
  • JDBC / ANSI SQL
  • Jaeger · Prometheus · Grafana
  • Datadog

Learnings

  • DB 성능만 좋아선 부족하다 — 데이터를 미들(producer)과 큐(Kafka)가 함께 받쳐줘야 제대로 된 시스템이 된다
  • 병목은 감이 아니라 구간별 측정으로 잡는다 — 최적화 전에 먼저 어디가 느린지 측정해야 한다
  • 안 보이는 구간(Spark 블랙박스)은 도구를 도입해서 뚫는다 — 직접 계측을 구현하는 대신 완성형 SaaS(Datadog)를 택한 것도 그 연장선
  • 저장소 특성(Hive = 배치 대량 적재)에 적재 방식을 맞추는 것이 튜닝보다 근본적인 개선일 때가 있다

Problem

실시간·배치 데이터 모두 건by건으로 single query statement를 JDBC 인터페이스를 통해 DB에 적재하는 구조였습니다. 주 적재 대상인 Hive는 대량 배치 적재에 적합한데도 쿼리를 건by건으로 처리해 실제 적재 성능이 낮았습니다.

여기에 Kafka가 복제·내결함성에 필요한 최소 3개 broker가 아닌 단일 broker로 구성돼 pub/sub 구간이 병목이었고, HBase는 표준 SQL과 문법이 달라 상단에 Apache Phoenix를 두고 ANSI 질의를 변환해 적재하는 구조라 완전히 매끄럽지 않았습니다.

무엇보다 Spark 내부 구간이 블랙박스라 병목 지점을 정확히 짚기 어려웠습니다.

Approach

플랫폼 구축

Spring Boot Producer가 기상청 API Hub의 종관기상관측(ASOS) 데이터를 Kafka로 발행하고, Flink Kafka Consumer가 스트림을 변환해 HDFS에 적재하는 경로를 구성했습니다.

저장소는 1TB 로그 데이터 기준 성능 비교 결과에 따라 배치는 Hive(Tez 실행 엔진, PostgreSQL Metastore), 실시간은 HBase(Phoenix Query Server)로 나눴고, ZooKeeper 3노드·Kafka 3 Broker·NameNode 2대·DataNode 3대·HiveServer 2대를 Docker Compose로 구성했습니다.

적재 성능 개선

먼저 Jaeger·Prometheus·Grafana로 각 데이터 ingest 구간의 소요시간을 측정해 병목 지점을 특정했습니다.

저장소(DB) 트랜잭션만 빨라선 소용없고 미들(producer)과 큐(Kafka)가 함께 받쳐줘야 한다는 관점에서, 건by건 single-statement 적재를 벌크/배치 적재 방식으로 바꾸고, Kafka를 단일 broker에서 복제·내결함성을 확보하는 다중(3) broker 구성으로 전환해 pub/sub 병목을 해소했습니다.

HBase 접근은 Phoenix 경유 ANSI→HBase 변환 계층을 유지했습니다. Spark 내부처럼 자체 계측이 어려운 블랙박스 구간은 Datadog(SaaS)을 도입해 관측을 대체했습니다.

Key Decisions

저장소 역할 분리 — 1TB 로그 성능 비교로 배치는 Hive, 실시간은 HBase
Reasoning:

ElasticSearch·Hive·HBase를 1TB 로그 데이터로 검색 속도, 처리량, 저장 효율, 리소스 사용률, 확장성 5개 영역에서 비교했습니다. HBase는 1,500 TPS로 처리량이 가장 높고 단일 키 조회도 30ms로 ElasticSearch(20ms)에 근접하면서 메모리 사용률은 50%로 더 낮아 실시간 처리에 적합했습니다. Hive는 키 조회가 2,000ms로 느리지만 압축률 40%, 1TB 기준 저장 공간 600GB, 노드 확장 시 성능 변화 80%로 저장 효율과 확장성이 가장 좋아 배치 관리에 맞았습니다. ElasticSearch는 검색 속도는 가장 빨랐지만 CPU 75%·메모리 80%로 리소스 사용률이 가장 높고 압축률이 20%로 낮아, 대규모 적재 저장소에서는 제외했습니다.

Alternatives considered:
  • ElasticSearch로 검색·적재 통합
  • Hive 단일 저장소로 통합
Hadoop 3.3.6 기준으로 HBase·Phoenix 버전 조합을 검증한 뒤 상향
Reasoning:

HBase와 Phoenix는 Hadoop 버전과의 호환성에 따라 구성 내용이 달라집니다. HBase 1.3.6 + Phoenix 4.14.3 조합과 HBase 2.0 + Phoenix 5.0.0 조합을 각각 Hadoop 3.3.6에서 호환성 테스트한 뒤 상위 조합으로 구성했습니다.

Alternatives considered:
  • HBase 1.3.6 + Phoenix 4.14.3 조합 유지
건by건 single-statement 적재 → 벌크/배치 적재로 전환
Reasoning:

실시간·배치 데이터를 모두 건by건 single query statement로 JDBC 적재하고 있었고, 주 대상인 Hive는 대량 배치 적재에 적합한 저장소라 이 방식과 상성이 나빴습니다. 적재 단위를 벌크/배치로 바꿔 저장소 특성에 맞는 처리량을 확보했습니다.

Alternatives considered:
  • single-statement 유지 + DB 튜닝
  • 저장소 자체 교체
Kafka 단일 broker → 복제·내결함성을 위한 다중(3) broker 구성
Reasoning:

pub/sub 구간이 단일 broker라 데이터가 원활히 흐르지 못하는 병목이었습니다. 다중 broker(최소 3) 구성으로 전환하고 토픽을 복제 계수 3(Leader 1, Follower 2)으로 구성해, broker 한 대에 장애가 나도 Follower가 Leader로 승격되어 서비스가 이어지도록 했습니다. 이를 통해 producer→queue→저장소로 이어지는 흐름의 처리량과 안정성을 높였습니다.

Alternatives considered:
  • 단일 broker 유지 + 파티션·컨슈머 튜닝
  • 다른 메시지 큐로 교체
블랙박스 구간 관측을 위해 Datadog(SaaS) 도입
Reasoning:

Jaeger·Prometheus·Grafana로 구간별 측정은 가능했지만 Apache Spark 내부는 세부 성능 지표를 외부에서 측정할 수 없는 블랙박스였습니다. 직접 일일이 계측을 구현하는 대신 완성된 관측 서비스인 Datadog을 도입해 Spark 구간까지 end-to-end 가시성을 확보했습니다.

Alternatives considered:
  • Spark 계측을 자체 구현
  • Jaeger·Prometheus·Grafana 스택만 확장

Result & Impact

  • 1TB 로그 기준 ElasticSearch·Hive·HBase 5개 영역 비교
    저장소 비교
  • 1,500 TPS · 단일 키 조회 30ms
    HBase (실시간)
  • 압축률 40% · 1TB 기준 저장 공간 600GB
    Hive (배치)
  • ZooKeeper 3 · Kafka 3 · NameNode 2 · DataNode 3 · HiveServer 2
    플랫폼 구성
  • 건by건 single-statement JDBC → 벌크/배치 적재 전환
    적재 방식
  • 단일 broker → 3 broker (복제·내결함성 확보)
    Kafka 구성
  • Spark 블랙박스 구간까지 end-to-end 가시성 (측정 불가 → 측정 가능)
    관측 커버리지

저장소 하나만 최적화하는 대신 미들(producer)·큐(Kafka)·저장소를 end-to-end로 함께 개선해, 감에 의존하던 병목 진단을 구간별 측정 기반으로 전환했습니다. Spark처럼 자체 계측이 어려운 구간까지 Datadog으로 관측 범위를 넓혀, 병목 지점을 빠르게 특정하고 적재 처리량을 개선했습니다.