실무
AI 스마트 플랜트 모니터링 플랫폼
플랜트 설비(압축기·터빈)의 센서 46개 태그를 폐쇄망 PI 시스템에서 수집·정규화하고, 외부에서 개발된 AI 모델(진단·예측·추천)을 Zeppelin 기반 이관 파이프라인에 통합해 웹으로 실시간 시각화한 설비 모니터링 시스템을 구축하고 2개 고객사 실증을 수행
Overview
석유화학·가스 분야 플랜트 고객사를 대상으로 한 설비 모니터링 시스템의 데이터 엔지니어링과 시스템 통합을 담당했습니다. 기존 폐쇄망에서 압축기·터빈 설비의 실시간 센서 데이터를 수집하던 PI 시스템에서 데이터를 수집하여 MS SQL에 적재하고, 외부에서 개발된 진단·예측·추천 AI 모델을 실제 운영 파이프라인에 통합해 결과를 웹으로 시각화하는 구조입니다. 수집 데이터가 여러 모델에서 공용으로 쓰여 데이터 정합성 확보가 핵심 요구였습니다.
System Architecture
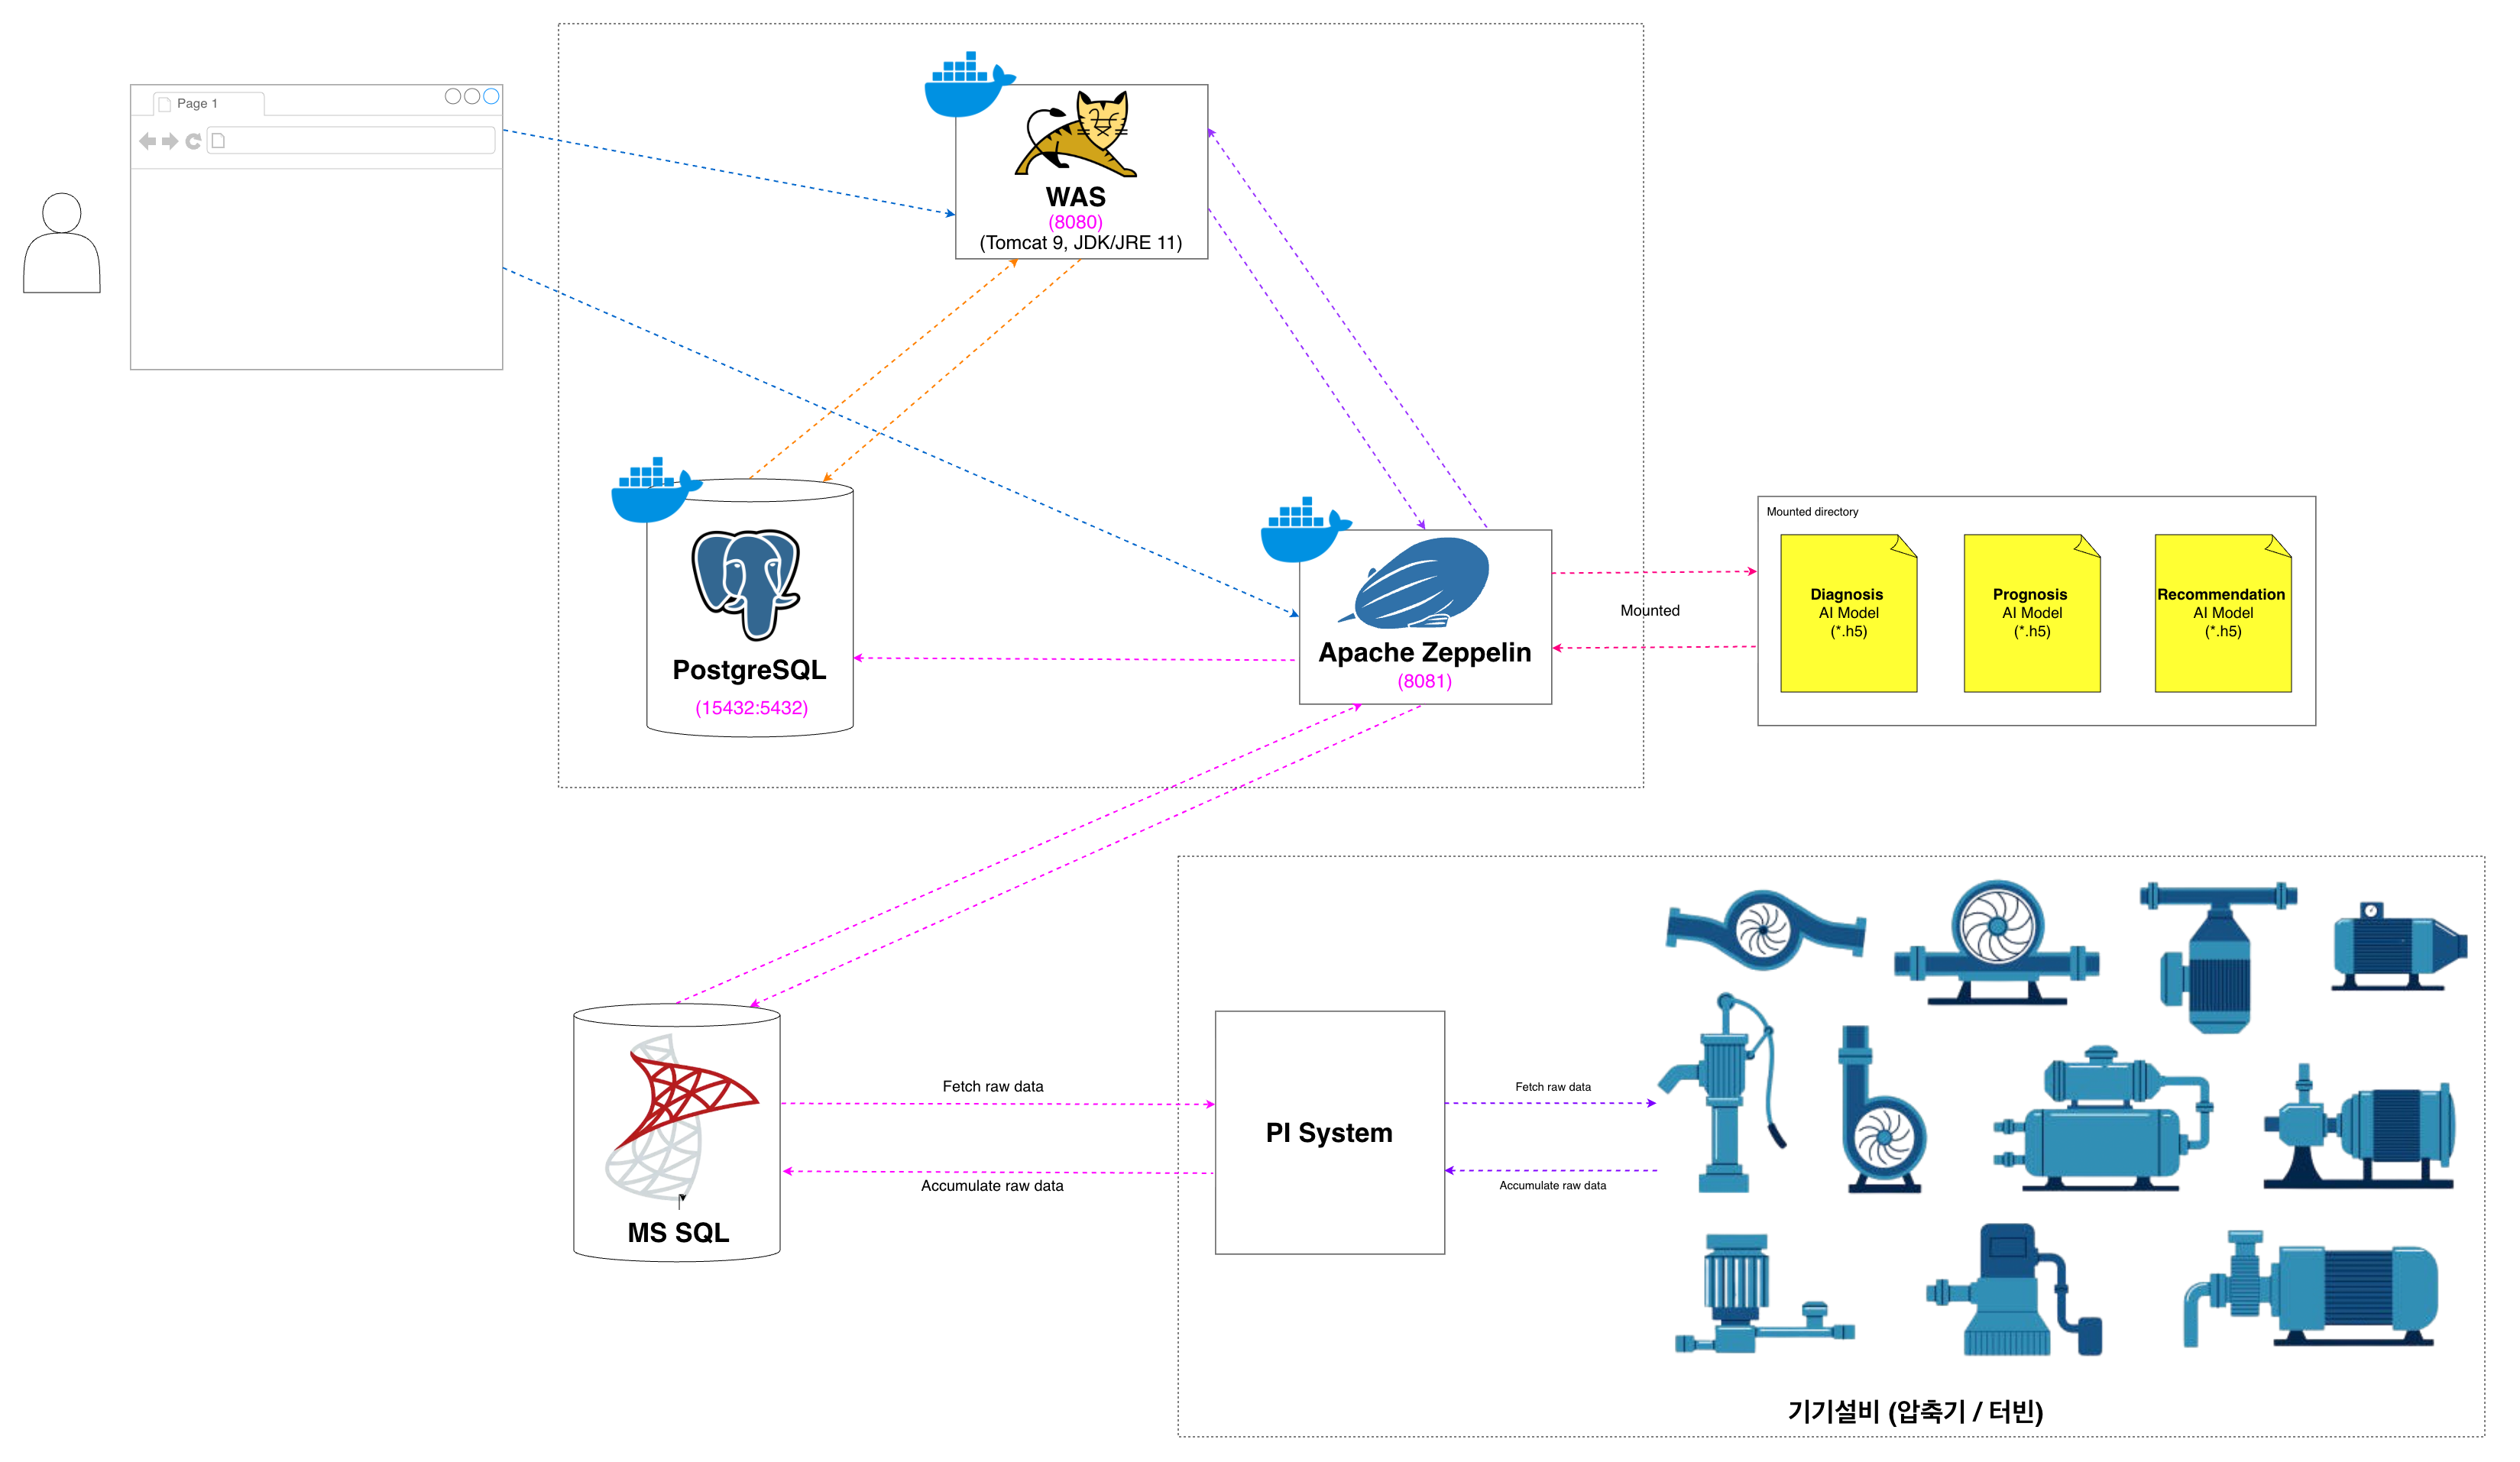
Constraints
- 폐쇄망 + 보안 이관 — 외부 개발 측은 실제 센서 매핑을 알 수 없고 현장에서만 확인 가능
- 서버로 쓸 PC 사양·여력이 낮은 현장 하드웨어에서 운영
- 원본 데이터를 여러 AI 모델이 공용 — 데이터 정합성 확보 필수
- 이상 데이터 극소수 — 클래스 불균형 (정상/이상 판별을 위한 패턴)
- 고객사별로 데이터 확보 조건이 상이 (실데이터 반출 가능/불가)
Tech Stack
- Python (pymssql / psycopg2)
- Apache Zeppelin
- MSSQL (원본 1차 적재)
- PostgreSQL (앱 RDB)
- PI System (실시간 수집원)
- librosa (시계열 프레이밍) / SciPy (savgol 스무딩)
- TensorFlow (.h5 진단·예측·추천 모델)
Learnings
- AI 모델을 만든 것과, 그 모델을 실제 운영 파이프라인에 통합해 돌아가게 하는 것은 다른 일 — 통합·운영 관점에서 데이터 정합성과 정규화 기준(calibration range)을 잡는 것이 핵심이었다
- 기술 선택은 이상적 스택이 아니라 현장 제약(저사양 폐쇄망)에서 결정해야 한다 — Airflow 대신 Zeppelin을 고른 이유이자, 데이터가 커지면 Airflow로 가야 한다는 경계도 함께 알아야 한다
- 정상/이상 데이터 불균형은 모델 성능의 근본 제약 — residuals_max×ratio 같은 임계 보정은 대증적 대응이고, 뿌리는 정상·이상 데이터를 충분한 양으로 확보하지 못한 데 있다 (프로젝트 기간 내 미해결 과제로 남김)
- 고객사별로 데이터 확보 조건이 달라 검증 방식도 달라졌다 — 실데이터 반출이 불가한 고객사는 센서 calibration range 기반으로 합성 테스트 데이터를 생성해 검증했는데, 동작 검증엔 충분했지만 이상 탐지 성능 검증에는 한계가 있었다